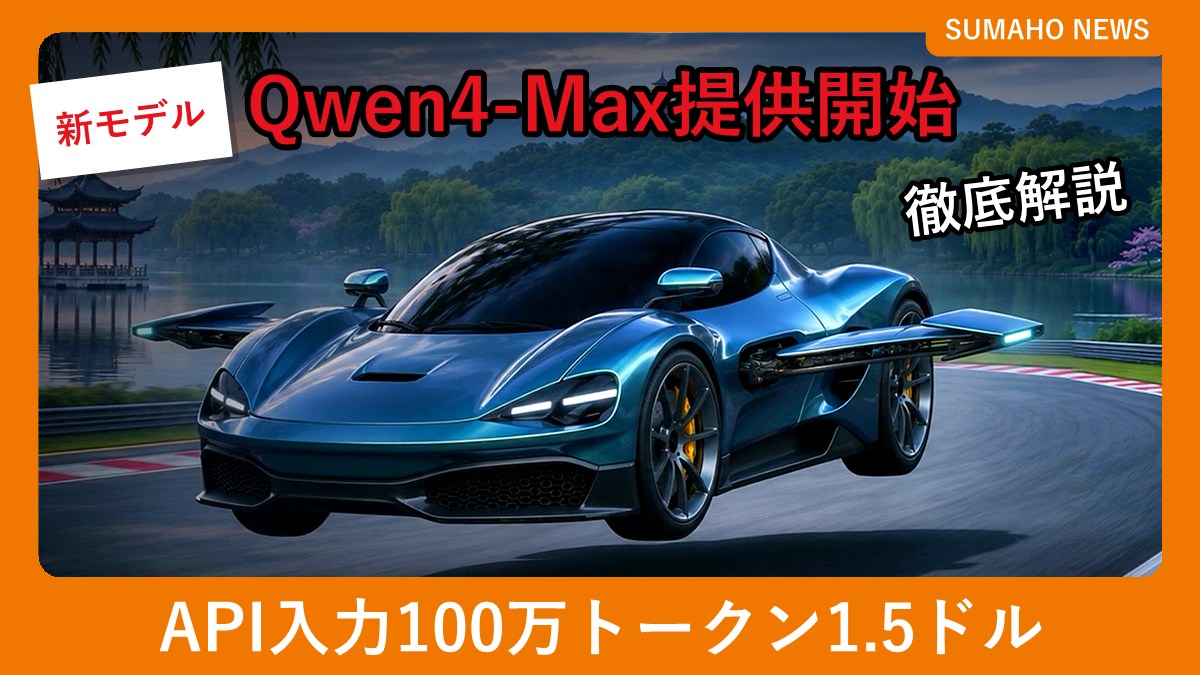
AlibabaのAI開発チーム「Qwen」は2026年11月16日(日本時間)、次の世代「Qwen4」シリーズの最上位モデル「Qwen4-Max」を発表し、クラウドサービス「QwenCloud」のAPIなどで提供を始めました。総パラメータ数は2.4兆、一度に読み込める量は100万トークンで、APIの料金は100万トークンあたり入力1.5ドル・出力4.5ドルです。仕事の道具を使いこなし、長い作業を最後までやり切る「24時間働くAIの同僚」をうたっています。
Qwen4-Maxの概要
Qwenは、ChatGPTやGeminiと同じ種類の大規模言語モデル(LLM)を作っているAlibaba社内のチームです。これまで「Qwen3.8-Max」が最上位でしたが、今回からモデルの中身の作り(アーキテクチャ)を一新した「Qwen4」世代に移りました。発表の要点は次のとおりです。
| 項目 | 内容 |
|---|---|
| 発表 | 2026年11月16日(日本時間) |
| 位置づけ | Qwen4シリーズの最上位モデル(Qwen3.8-Maxの後継) |
| パラメータ数 | 本体2.4兆(1トークンあたり使うのは710億)+N-gram Embedding用3,280億 |
| 入力できるもの | テキスト・画像・動画(出力はテキスト) |
| コンテキスト | 100万トークン(最大入力は約99万1,000トークン) |
| 最大出力 | 13万1,000トークン(思考モードでは26万2,000トークン) |
| API料金(100万トークンあたり) | 入力1.5ドル/出力4.5ドル/キャッシュ入力0.075ドル |
| 使えるところ | QwenCloud(API・Token Plan)、QwenWork、Qoder、Qwen Studio |
| モデルの重みの公開 | Qwen4-Max自体は未公開。同じ世代の小さいモデルを今後オープンソースで公開予定 |
APIはOpenAIとAnthropicの形式に合わせた呼び出し方ができ、Web検索、外部ツールの呼び出し(Function Calling)、決まった形のJSONで答えさせる機能、まとめて処理して費用を下げるバッチ処理、追加学習(ファインチューニング)にも対応しています。
新しいアーキテクチャで何が変わったか
Qwen4-Maxは、必要な部分だけを動かす「MoE(Mixture of Experts)」という方式のモデルです。全体は2.4兆パラメータと非常に大きいものの、1つの単語(トークン)を処理するときに働くのは710億パラメータだけなので、規模の割に計算量を抑えられます。Qwenは今回、次の3つの仕組みを新しく取り入れました。
長い文章を安く読むための「GDN+QSA」
長い文書を読むほど計算が重くなるという大規模言語モデルの弱点に対して、過去の内容を一定の大きさに圧縮する層(Gated DeltaNet)と、関係のありそうな部分だけを小さな単位で選んで読む「Qwen Sparse Attention(QSA)」を組み合わせています。100万トークンという長い入力を、現実的な費用で扱うための工夫です。
学習を安定させる「Gated Residual」
層と層のあいだで情報を受け渡す経路を4本に増やし、それぞれに読み書きの量を調整する「ゲート」を付けました。Qwenは、2.4兆パラメータという規模でも学習中に誤差が急に跳ね上がることがなく、なめらかに学習が進んだとしています。
少ない計算で容量を増やす「N-gram Embedding」
よく一緒に出てくる単語の並びを、計算ではなく表を引く形で取り出す仕組みです。計算量をほとんど増やさずにモデルの知識の容量を広げられるとしています。学習直後のベースモデルの社内評価では、知識・コード・質問応答・理数系のすべてで前世代より約5〜13%よい結果になり、そのうえ動かすパラメータは25%少なくなったと説明しています。
ベンチマークでの実力:他社の最上位モデルとの比較
Qwenは、Qwen4-Maxを前世代のQwen3.8-Max、AnthropicのClaude Opus 5.5、OpenAIのGPT6.1-SolとGPT6-Astra、Moonshot AIのKimi K3.1と比べた結果を公開しています。主な項目を抜き出すと次のとおりです(数値はQwenの公式発表の図から読み取ったもの。太字は6モデル中の最高値)。
| テスト(内容) | Qwen4-Max | Qwen3.8-Max | Claude Opus 5.5 | GPT6.1-Sol | Kimi K3.1 |
|---|---|---|---|---|---|
| DeepSWE v1.1(AIによるプログラミング) | 75.7 | 69.3 | 74.2 | 75.2 | 75.5 |
| Agents’ Last Exam v1.1(長時間の作業) | 46.7 | 27.9 | 43.4 | 42.6 | 43.4 |
| HLAB-Vals-1.1(法務の作業) | 21.3 | 15.4 | 9.2 | 6.3 | 11.7 |
| Terminal-Bench 4.0(コマンド操作) | 48.5 | 38.9 | 59.6 | 56.1 | 67.2 |
| JobBench(職業上の作業) | 68.5 | 65.3 | 75.4 | 66.2 | 61.2 |
| Humanity’s Last Exam(幅広い分野の難問) | 51.7 | 43.9 | 59.8 | 54.0 | 51.1 |
前世代からはほぼすべての項目で伸びており、とくに長時間かけて進める作業(Agents’ Last Exam)は27.9から46.7へ大きく上がりました。プログラミングや法務の作業では他社の最上位モデルを上回る一方、コマンド操作や難問の正答率ではClaude Opus 5.5やKimi K3.1に届いていません。「何でも一番」ではなく、長い仕事を任せる用途に強いモデルといえます。
Qwen独自の仕事の評価「Work360」(26の分野・721の専門領域の作業をまとめたもの)では、前世代の47.74から52.69に上がりました。
少ないトークンで答える=実際の費用が下がる
Qwenが強調しているのが「効率」です。Work360で同じ作業をさせたときに使うトークンの量は、思考の深さが最も高い設定で約24%、高い設定で約35%減りました。Terminal-Bench 4.0では約48%・約49%減っています。
APIの単価も前世代より下げ、とくにキャッシュ入力(同じ前置きの文章をくり返し送るときの割安な料金)を大きく値下げしたとしています。単価の値下げと使うトークンの減少が重なった結果、Work360の1つの作業にかかる平均の費用は4.43ドルから1.67ドルへ、62%下がったと説明しています。
Qwen4-Maxでできること
発表では、文章を書くだけでなく、ソフトウェアを操作して成果物を仕上げる例が数多く紹介されました。
- 3Dモデリング:Blenderを操作して形を作り、材質や照明を設定してレンダリングまで行う(この記事の画像はその作例)
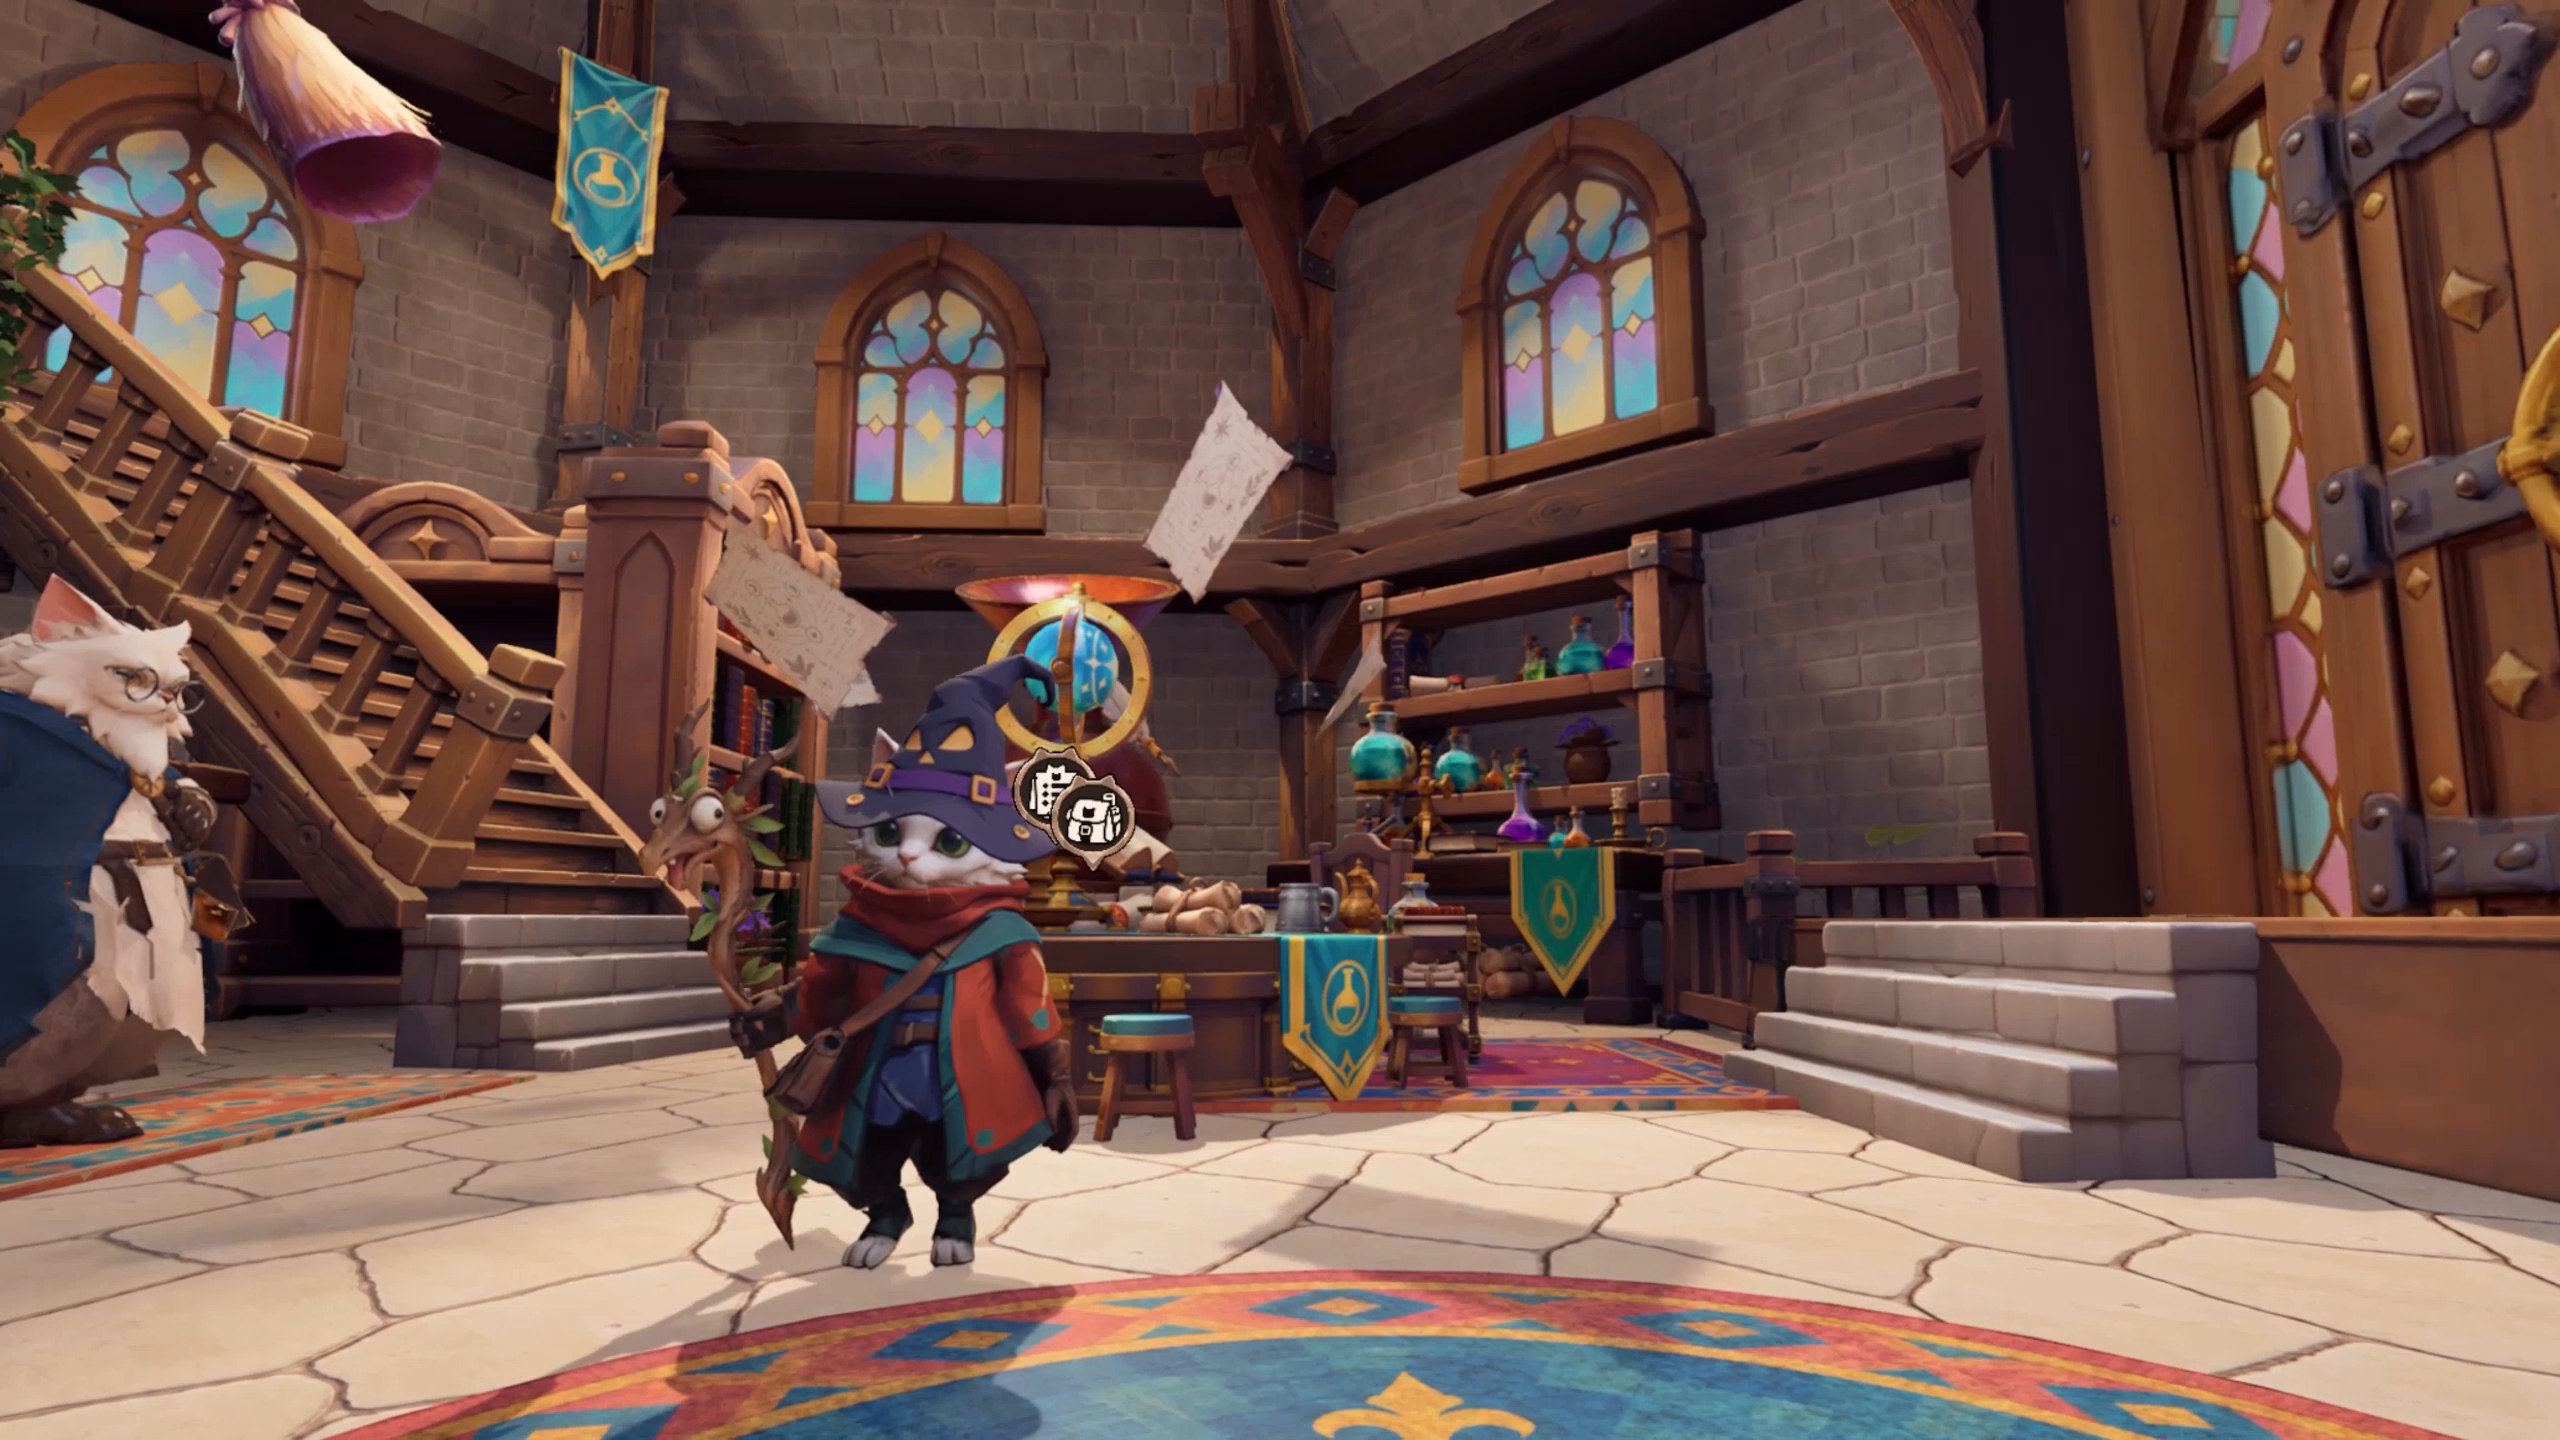
- ゲーム開発:Unity・Unreal Engine・Godotを使い、短い説明文から実際に遊べる3Dゲームを作る。Unreal Engineで猫の魔法使いが戦うゲームを作った例も公開
- 製造業:自動車の生産ラインの3Dモデル化や部品の設計・加工の確認。1つの部品の加工プログラムを作る手間が約475分から24分に減った事例を紹介
- 金融・法務・医療:90種類のツールを呼び出して市場データを集め、Excelと編集できるPowerPointで資料を作る例や、198件の書類を整理して86ページの報告書にまとめる例など
- 長時間の作業(Live Delivery):最初に使える版を早めに出し、利用者の指示を受けながら改良を重ねる進め方。そのためのプラグインもオープンソースで公開
料金と使い方
API料金
| 区分 | 100万トークンあたり |
|---|---|
| 入力 | 1.5ドル |
| 出力 | 4.5ドル |
| 入力(自動キャッシュ) | 0.075ドル |
| 明示キャッシュの作成(5分) | 1.875ドル |
| 明示キャッシュの作成(1時間) | 3ドル |
| 明示キャッシュの読み出し | 0.075ドル |
※QwenCloudのシンガポール(ap-southeast-1)リージョンのモデルページに表示されている料金です。
使えるサービス
開発者はQwenCloudでAPIキーを取得して使うか、定額制の「Token Plan」を選べます。プログラムを書かずに試したい場合は、チャット形式で使える「Qwen Studio」、仕事向けの「QwenWork」、AIでプログラミングする開発ツール「Qoder」でもQwen4-Maxを選べるとしています。なお、これらのアプリでの利用料金や無料で使える回数は、今回の発表では示されていません。
独自の考察:誰が使うと得をするモデルか
GeminiやClaudeとの料金の比べ方
入力1.5ドルという単価は、Googleが11月12日に出した「Gemini 4 Hydrogen」と同じです。Hydrogenの出力は100万トークンあたり7.5ドルなので、出力はQwen4-Maxのほうが4割安くなります。たとえば入力100万トークン・出力10万トークンの作業なら、Qwen4-Maxは1.95ドル、Hydrogenは2.25ドルです。ただしAIの費用は単価だけでなく、同じ作業に何トークン使うかで大きく変わります。Qwenが「少ないトークンで答える」ことを強く打ち出しているのはこのためで、実際に自分の作業で試して1件あたりの費用を比べるのが確実です。
向いている人
- 長い資料の読み込みや、何十回もツールを呼び出すAIエージェントを作りたい開発者
- OpenAIやAnthropicのAPIからの乗り換えを、少ない書き換えで試したい人
- 出力の多い作業(コードの生成、長い報告書)を安く回したい企業
注意しておきたい点
日本の一般の利用者にとっては、ChatGPTやGeminiのようにスマホアプリで日常的に使う形よりも、開発者向けのAPIとしての存在感が大きいモデルです。会社の資料を送る場合は、どの国・地域のサーバーで処理されるか、データの扱いの規約を事前に確認しておきましょう。また、Qwenは過去の世代で多くのモデルの重みを公開してきましたが、Qwen4-Max本体は公開されておらず、手元のPCで動かすことはできません。PCで動かしたい人は、今後公開予定の小さいQwen4モデルを待つことになります。
よくある質問
Qwen4-Maxは無料で使えますか?
APIは使った量に応じた有料です。Qwen Studioなどのアプリでの料金や無料で使える範囲は、今回の発表では明らかにされていません。
日本語は使えますか?
発表では対応言語の一覧は示されていません。Qwenのモデルはこれまで多言語に対応してきましたが、Qwen4-Maxの日本語の精度は公式には示されていないため、実際に試して確認するのがおすすめです。
画像や動画も読み込めますか?
はい。テキストに加えて画像と動画を入力でき、内容を理解して答えられます。出力はテキストのみで、画像や動画を生成するモデルではありません。
自分のPCで動かせますか?
Qwen4-Max自体のモデルの重みは公開されていないため、動かせません。Qwenは同じ世代の小さいモデルを今後オープンソースで公開するとしていますが、時期は未発表です。
まとめ
Qwen4-Maxは、アーキテクチャを一新して2.4兆パラメータ・100万トークンに対応した、Alibabaの新しい最上位AIモデルです。長時間の作業やプログラミング、法務などでは他社の最上位モデルを上回る結果を示し、同じ作業に使うトークンを減らしたことで、1件あたりの費用は前世代より6割ほど下がったとしています。APIは入力1.5ドル・出力4.5ドルと手ごろで、OpenAI・Anthropic形式で呼び出せるため、AIエージェントを作る開発者には試す価値のある選択肢です。一方、コマンド操作や難問ではClaude Opus 5.5などに及ばない項目もあり、用途に合わせた使い分けが前提になります。